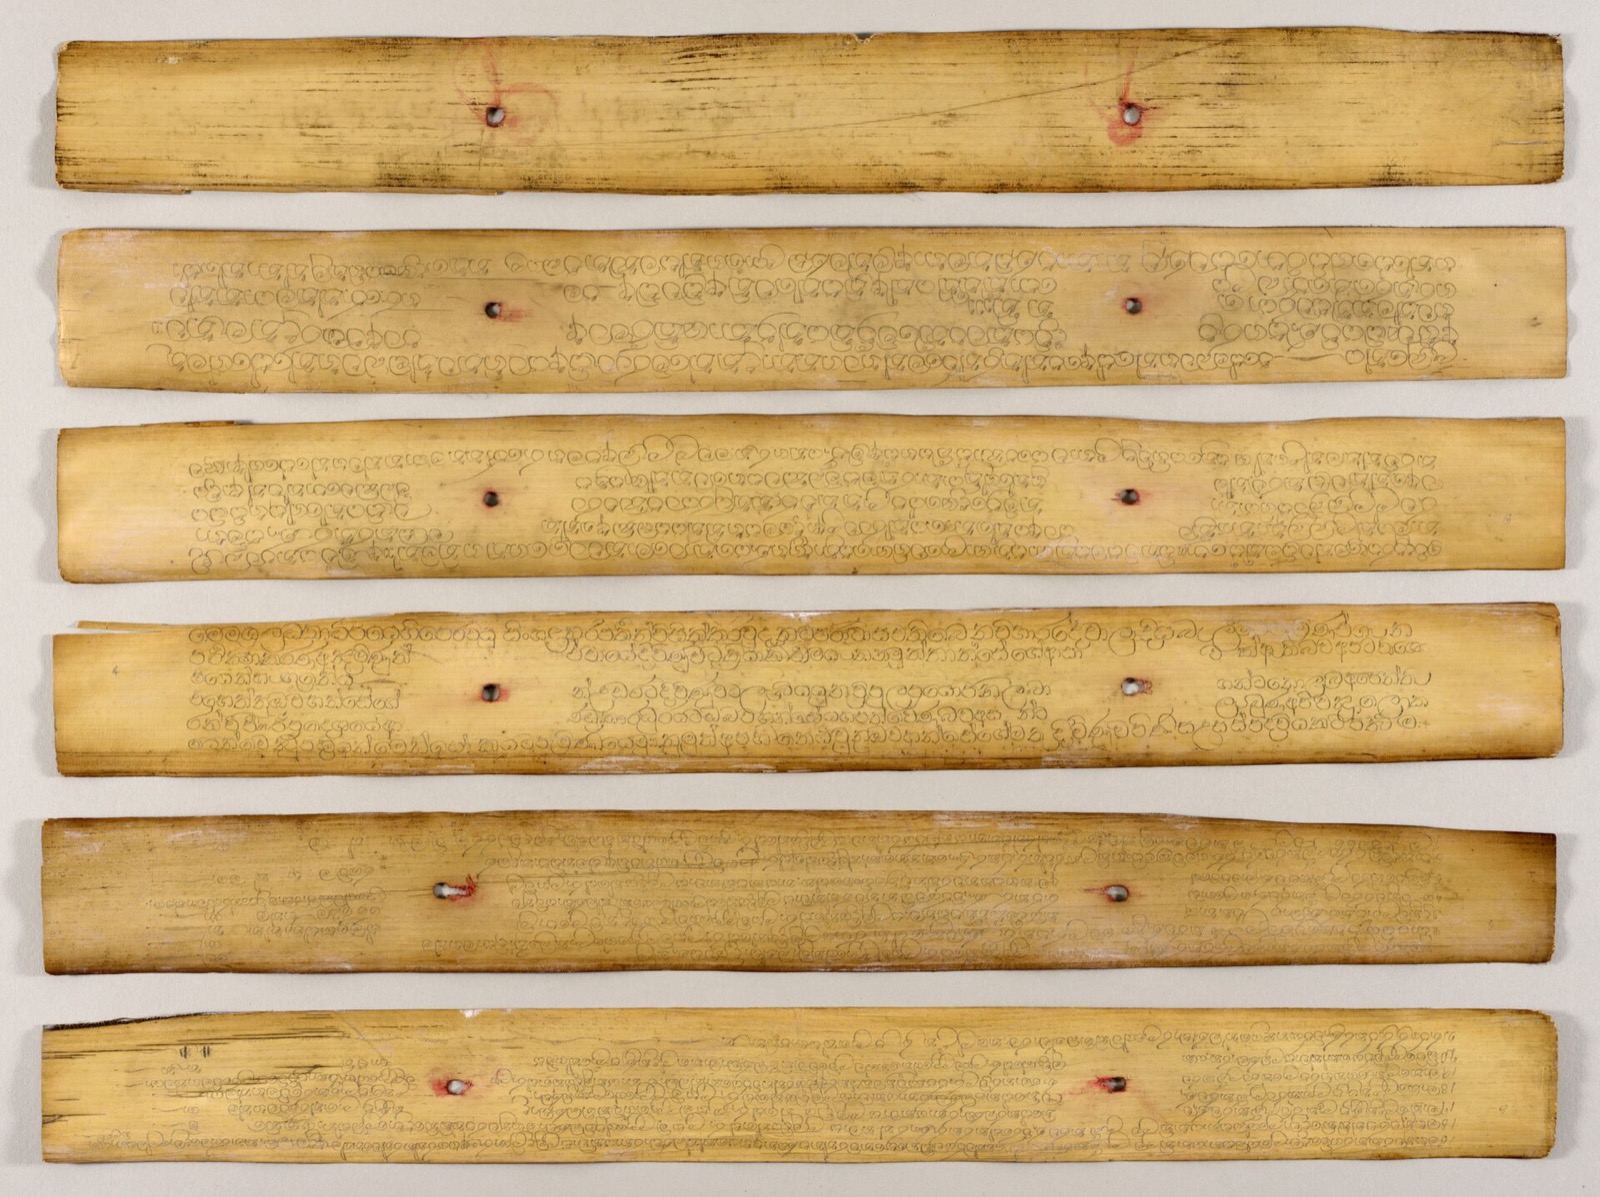
Полезный датасет буддийских текстов позволяет найти страницу, из которой взята цитата. Для первого OCR-пилота предлагаем запись об одной странице вместо набора неопознанных файлов. Начальные восемь полей: произведение, издание, идентификатор страницы, письменность, ссылка на источник, статус доступа, разрешение на предполагаемое использование и статус исправления. Это предложение, а не универсальный стандарт каталогизации.
Различайте исходное изображение, машинную расшифровку и исправленный текст. Фиксируйте, кто и когда изменил чтение, не публикуя личные контакты волонтёра. Неизвестное разрешение остаётся неизвестным: доступный скан не доказывает, что разрешено любое последующее использование. BDRC сохраняет ограничения доступа и не может отменить авторские права других владельцев. [1]
Скачиваемый пример содержит вымышленные идентификаторы и не содержит текста рукописи. Это инструмент планирования, а не лицензированный датасет или уже состоявшееся сотрудничество с библиотекой. Прежде чем выбрать пять–десять реальных страниц, нужно подтвердить источник, допустимые способы использования и культурные ограничения, а затем согласовать с участником небольшой список проверки качества. Обучение модели потребует соответствующих отдельных разрешений. Ближайшая цель — прослеживаемое исправление, которое сможет проверить другой читатель.