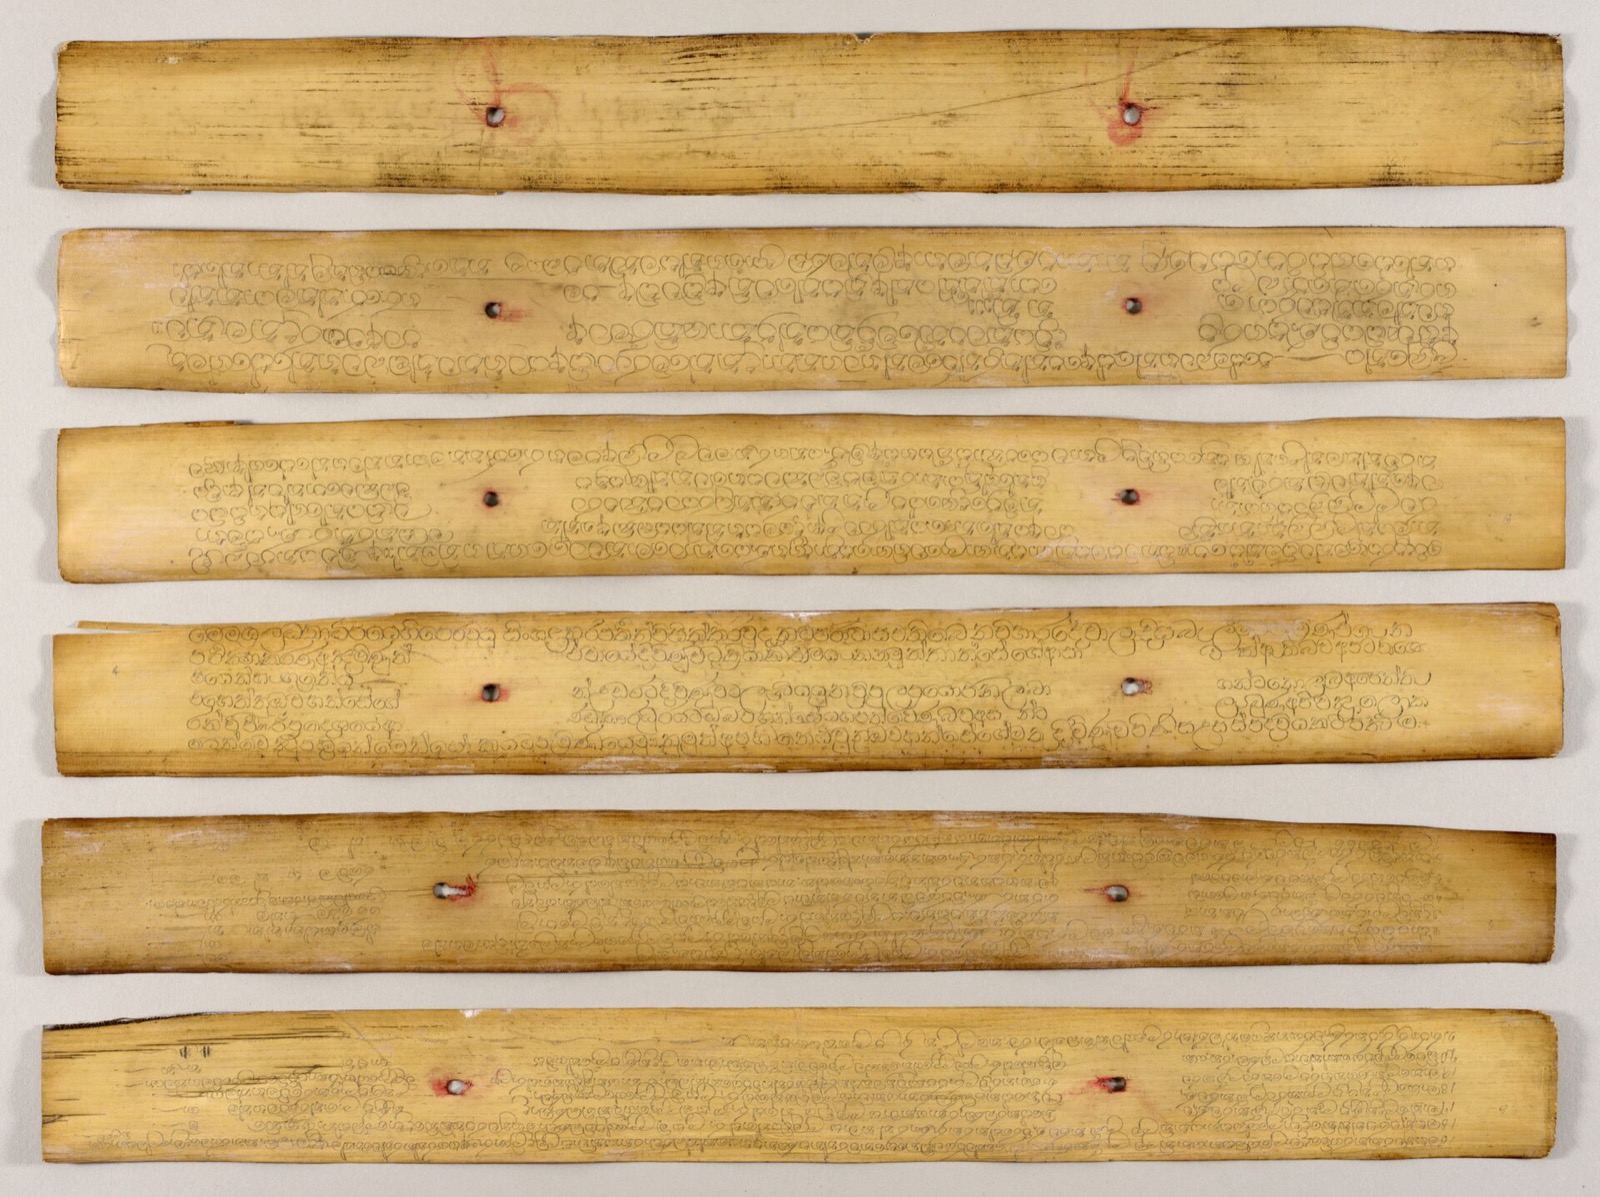
有用的佛教文本数据集应让读者找到引文对应的页面。首次 OCR 试点可以从一页记录开始,而不是收集身份不明的文件。我们提出八个起始字段:作品、版本、页面标识、文字系统、来源链接、访问状态、拟定用途的许可和修订状态。这些是建议字段,并非通用编目标准。
原始图像、机器转录和校订转录应当可以区分。记录谁在何时改动了某种读法,同时不公开志愿者的私人联系方式。未知的许可仍是未知:可见的扫描件不能证明后续所有用途都获授权。BDRC 保留访问限制,也不能放弃他人拥有的版权。[1]
可下载示例只含虚构标识,不含手稿文本。它是规划工具,并非获许可的数据集,也不代表已与图书馆建立合作。在选择五至十页真实材料前,我们会先确认来源、允许用途及文化限制,再与贡献者商定简要的质量检查表。模型训练需要适当的另行许可。眼前的目标是形成他人可检查、可追溯的校订。