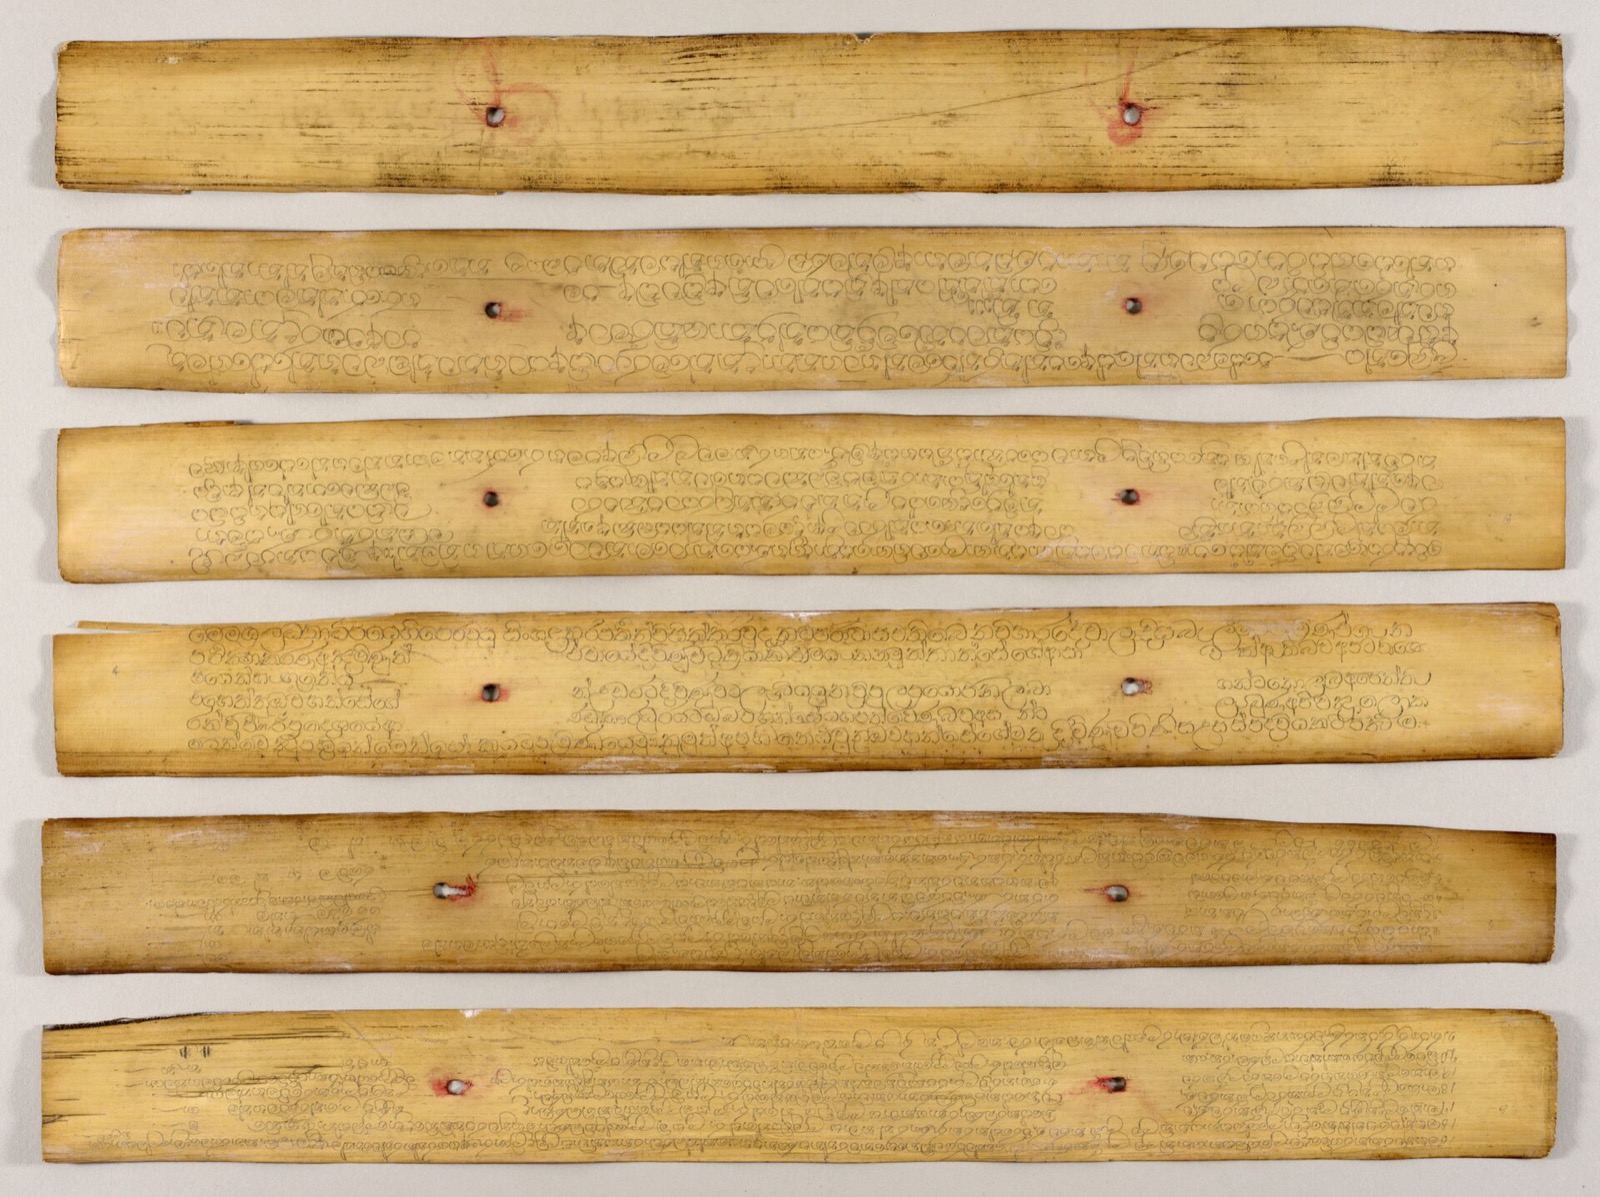
유용한 불교 문헌 데이터셋은 독자가 인용문의 원래 페이지를 찾을 수 있게 해야 합니다. 첫 OCR 시범 작업에서는 출처 불명의 파일 묶음 대신 한 쪽의 기록부터 시작하자고 제안합니다. 처음 사용할 여덟 항목은 저작, 판본, 페이지 식별자, 문자 체계, 출처 링크, 접근 상태, 예정된 용도의 이용 허락, 교정 상태입니다. 이는 제안 항목이며 보편적인 목록 작성 표준이 아닙니다.
원본 이미지, 기계 전사, 교정 전사를 구별할 수 있게 보존합니다. 누가 언제 판독을 바꾸었는지 기록하되 자원봉사자의 사적 연락처는 공개하지 않습니다. 허락 여부를 모르면 그대로 미확인이라고 기록합니다. 스캔을 볼 수 있다는 사실이 이후의 모든 이용이 허가되었다는 증거는 아닙니다. BDRC는 접근 제한을 유지하며 다른 권리자의 저작권을 포기시킬 수 없습니다. [1]
내려받는 예시에는 가상의 식별자만 있고 필사본 본문은 없습니다. 이는 계획을 돕는 도구이지 허가받은 데이터셋이나 이미 성립한 도서관 협력이 아닙니다. 실제 다섯~열 쪽을 고르기 전에 출처, 허용 용도, 문화적 제한을 확인하고 기여자와 작은 품질 점검표를 합의할 것입니다. 모델 학습에는 별도의 적절한 허락이 필요합니다. 당장의 목표는 다른 독자가 확인할 수 있는 추적 가능한 교정입니다.