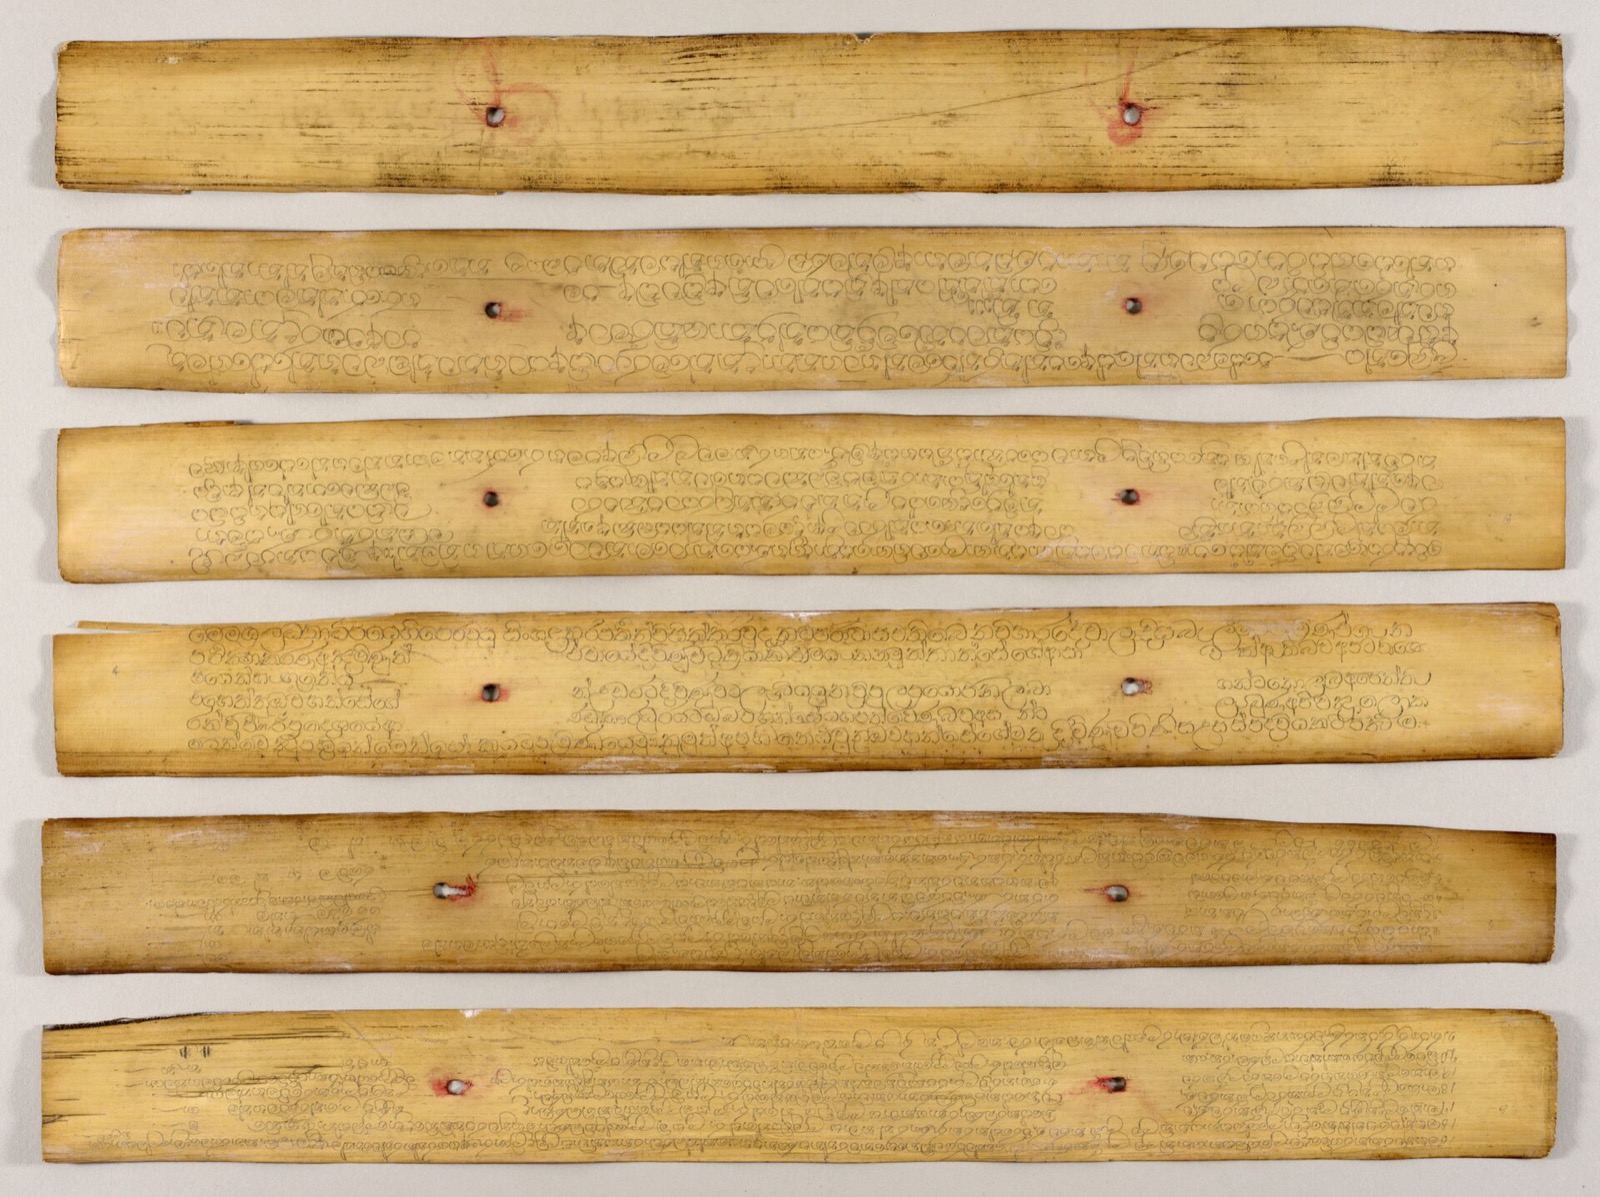
有用な仏教テキストデータセットでは、引用の元になった頁を読者が探せる必要があります。最初のOCR試行では、出所不明のファイル集ではなく、一頁の記録から始めることを提案します。最初の八項目は、著作、版、頁の識別子、文字体系、出典リンク、アクセス状況、予定する利用への許諾、校訂状況です。提案する項目であり、普遍的な目録規格ではありません。
原画像、機械による文字起こし、校訂済みテキストを区別できるようにします。誰がいつ読みを修正したかを記録し、ボランティアの私的な連絡先は公開しません。許諾が不明なら、不明のまま記録します。スキャンが見られることは、その後のあらゆる利用が許可された証拠にはなりません。BDRCはアクセス制限を設け、他者が持つ著作権を放棄することはできません。[1]
ダウンロードできる例には架空の識別子のみを用い、写本本文は含めていません。これは計画の補助であり、利用許諾を得たデータセットでも、図書館との成立済みの協力でもありません。実際の五〜十頁を選ぶ前に、出典、許される用途、文化的制限を確かめ、協力者と簡単な品質確認表を合意します。モデル学習には適切な別途の許諾が必要です。直近の目標は、他の読者が確認できる、追跡可能な校訂です。