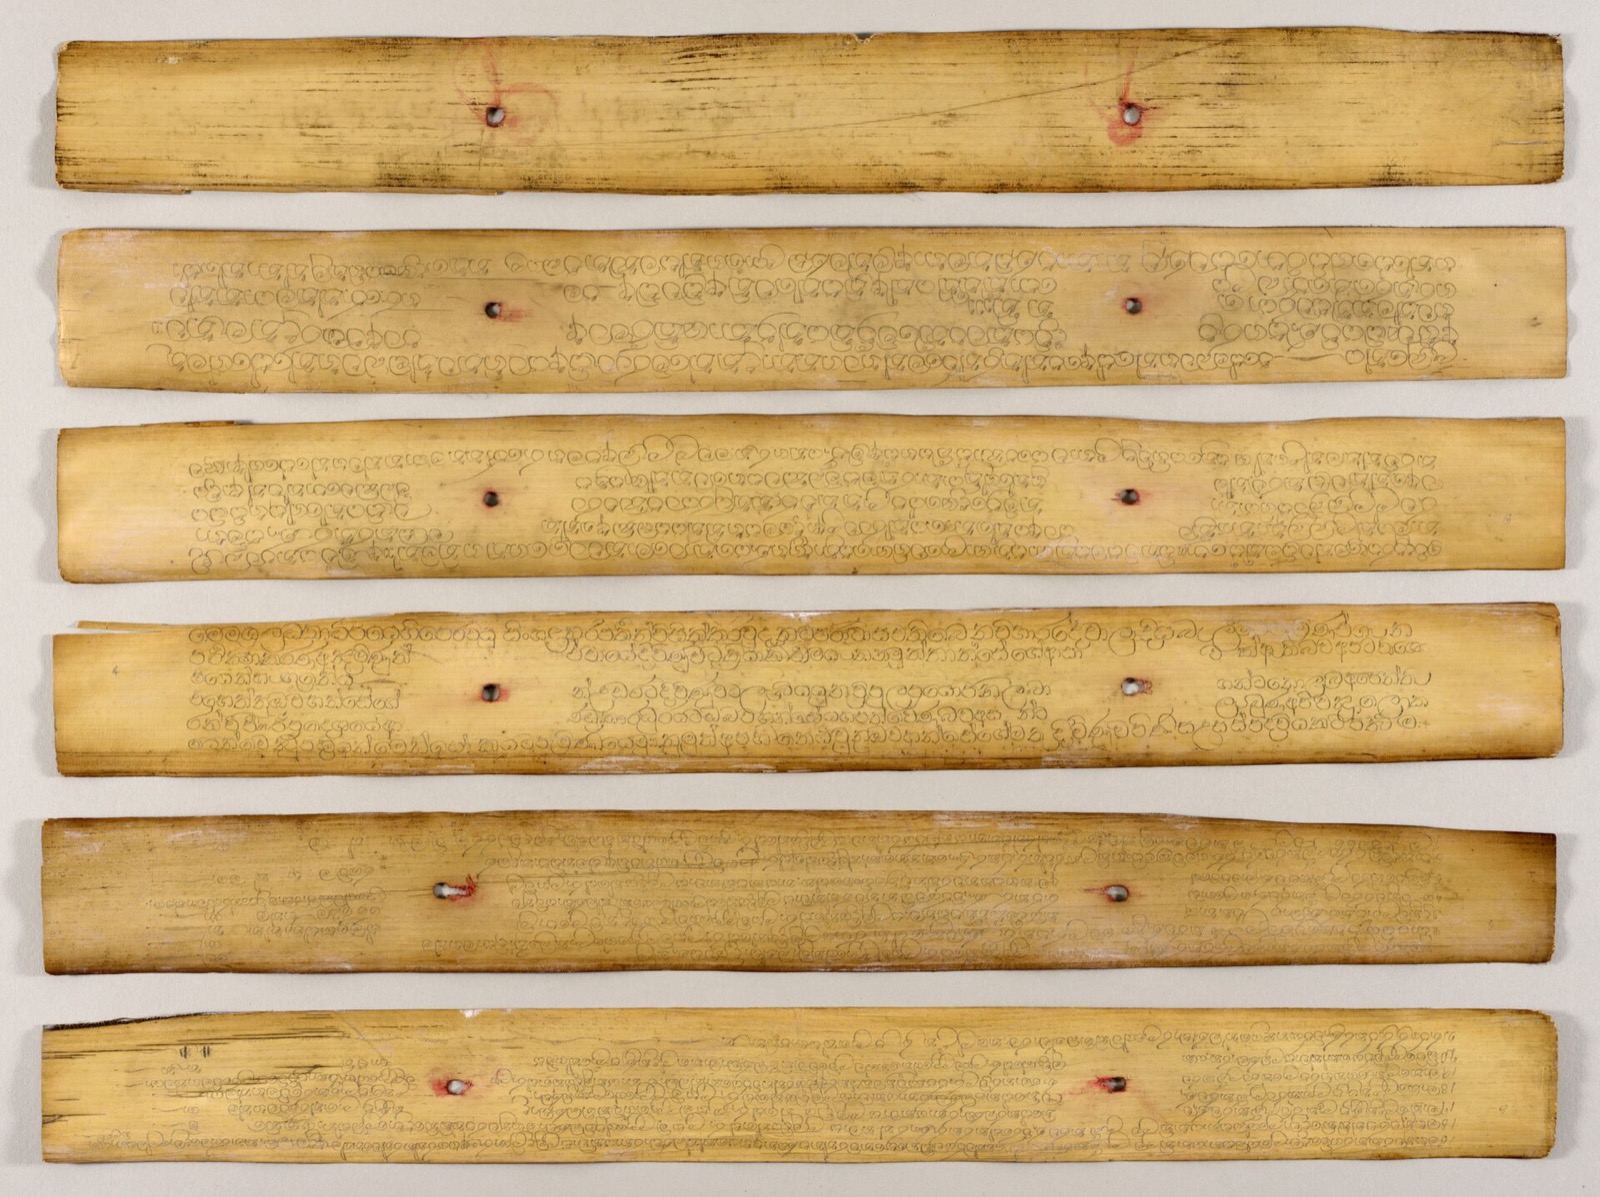
Một bộ dữ liệu văn bản Phật giáo hữu ích phải giúp người đọc tìm được trang gốc của câu trích dẫn. Với thử nghiệm OCR đầu tiên, chúng tôi đề xuất bản ghi cho một trang thay vì tập hợp những tệp không rõ nguồn. Tám trường ban đầu là tác phẩm, ấn bản, mã trang, hệ chữ, liên kết nguồn, trạng thái truy cập, quyền cho mục đích sử dụng dự kiến và trạng thái hiệu đính. Đây là các trường đề xuất, không phải tiêu chuẩn biên mục phổ quát.
Cần phân biệt ảnh gốc, bản chép máy và bản đã hiệu đính. Ghi ai thay đổi cách đọc và khi nào, nhưng không công khai liên hệ riêng của tình nguyện viên. Quyền chưa rõ phải được ghi là chưa rõ: xem được bản quét không chứng minh mọi cách dùng về sau đều được phép. BDRC duy trì các hạn chế truy cập và không thể từ bỏ bản quyền thuộc người khác. [1]
Ví dụ tải xuống chỉ có mã giả định, không có văn bản bản thảo. Đây là công cụ lập kế hoạch, không phải bộ dữ liệu đã được cấp phép hay quan hệ hợp tác thư viện đã thành lập. Trước khi chọn năm đến mười trang thật, chúng tôi sẽ xác nhận nguồn, cách dùng được phép và hạn chế văn hóa, rồi thống nhất danh mục kiểm tra chất lượng nhỏ với người đóng góp. Huấn luyện mô hình cần sự cho phép riêng phù hợp. Mục tiêu trước mắt là một bản hiệu đính có thể truy nguyên để người khác kiểm tra.