持续运行的环境
昼夜、天气、聚落、资源和日常活动构成共同的环境。即使没有观众,服务器也会继续模拟。
Matreya · 实验性研究计划
即使无人观看,这个世界也会继续运行。在这里,可以观察智能体如何记忆、行动、建立关系,以及如何回应自身选择带来的后果。
我们的长期目标是构建日益丰富的环境与智能体模拟,并借此研究记忆、行为与不同意识理论之间的关系。目前的Simsara是一个受古代印度启发的简化社会世界。它只模拟部分过程,并不完整再现物理现实。
探索城市、四座村庄和宫殿街区。选择一位居民,查看其活动、关系、记忆,以及被呈现为其当前想法的文字。模拟以规则为基础,并在语言模型可用时,偶尔纳入模型生成的内容。
正在检查公开世界的状态……
加载 Simsara 会连接由 Cloudflare 托管的模拟,后者会接收 IP 地址等连接信息。YouTube 音乐是单独的可选功能,加载游戏不会开启音乐。您可以不播放音乐而观看;播放器需要另行作出知情选择。 隐私与 Cookie
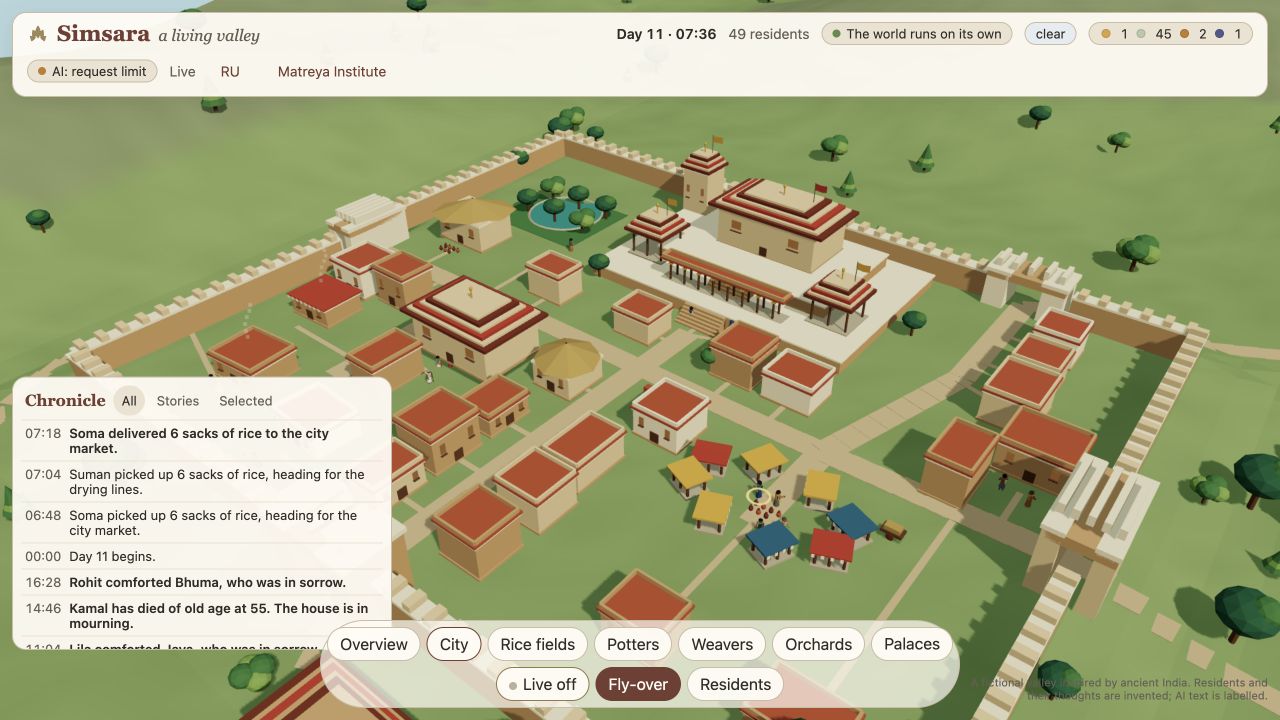
点击“进入观测站”后才会加载交互式世界。如需更大的显示空间,或浏览器无法在此显示世界,请在新标签页中打开。游戏界面默认使用中文,也可切换为英语或俄语。
昼夜、天气、聚落、资源和日常活动构成共同的环境。即使没有观众,服务器也会继续模拟。
居民保留记忆、计划、对话和关系。观测者可以通过可见记录,将实际发生的事件与智能体后来的叙述进行比较。
需求、情绪以及标为“喜悦”和“痛苦”的数值状态会影响虚构情节。这些是计算变量,并非对主观体验的测量。
系统包含衰老、死亡以及不同生命之间的虚构延续。其业力与转生机制是艺术性的建模选择,并非宗教或科学主张的证据。
这些是拟议中的研究。在报告结果之前,需要隔离的世界副本、受控设置、固定版本的模型,以及可导出的事件日志。公开演示并不是已经完成的实验。 [1] [3] [4]
Simsara可以帮助提出关于自我描述、记忆整合和能动性的问题。将生成的句子称为“想法”,并不能证明其具有觉知。行为观察和从理论推导出的指标可以引导研究,但目前本项目并没有证据表明其中的智能体具有主观体验。 [2]
相互依存、习惯性反应、意图与慈悲,为理解选择及其后果提供了提问的角度。不同佛教传统对心有各自的阐释。我们邀请修行者与学者结合计算方法审视我们的假设,同时将哲学解释与实验测量区分开来。
自主运行的公开世界、居民记录、对话和开放源代码。
带版本的状态快照、完整事件导出,以及可复现的实验运行工具。
预先说明研究方案的实验、独立复现,以及更丰富的环境与智能体行为模型。
Matreya × Simsara
欢迎开发者、学生、佛教学者和细心的观测者参与。有用的首次贡献可以是将一位居民的记忆与事件记录核对、审阅实验比较方案,或改进一段通俗说明。请通过研究所的表单提出你希望承担的任务。
这些出版物为我们的问题和拟议方法提供参考。它们并不验证Simsara,也不意味着其作者与本项目存在合作关系。
用于构建和评估行为可信的生成式智能体的架构,涵盖记忆、反思与规划。
基于理论讨论评估人工智能意识的相关指标,以及推断的局限。
长期交互记忆的评估框架,可为设计可核验的回忆任务提供参考。
用于研究语言智能体之间社会互动的环境与评估框架。
研究计划建设中 · 尚未报告实验发现 · 在人工智能辅助下编写